


La función SPLIT de Google Sheets divide el texto allí donde aparece un delimitador, como una coma o un espacio, y coloca cada fragmento en su propia celda. Es una forma rápida de separar nombres y apellidos o de convertir una lista separada por comas en columnas.
Así es como funciona:
Sintaxis
=SPLIT( text, delimiter, [split_by_each], [remove_empty_text] )
- texto – el texto o la cadena que quieres dividir.
- delimitador – un solo carácter o un grupo de caracteres que la función debe usar para dividir el texto. De forma predeterminada, cada carácter del delimitador se tiene en cuenta por separado. Por ejemplo, si el delimitador es "one", el texto se divide en torno a los caracteres "o", "n" y "e". Si no quieres este comportamiento, puedes establecer split_by_each en FALSE. Ten en cuenta que el delimitador no se incluye en el resultado de la función.
- split_by_each – [ OPCIONAL – TRUE de forma predeterminada ] – si mantienes la opción predeterminada, la función usa cada carácter de la cadena delimitadora para dividir el texto. Si lo estableces en FALSE, la función considera el delimitador como un todo. Puedes indicar este parámetro escribiendo TRUE o FALSE, o bien 1 o 0, respectivamente.
- remove_empty_text – [ OPCIONAL – TRUE de forma predeterminada ] – este parámetro indica si la función debe eliminar o no los fragmentos de texto vacíos del resultado. El comportamiento predeterminado es tratar los delimitadores consecutivos como uno solo (si es TRUE). Si es FALSE, se añaden celdas vacías entre los delimitadores consecutivos. Puedes indicar este parámetro escribiendo TRUE o FALSE, o bien 1 o 0, respectivamente.
Cómo utilizar la función SPLIT en Google Sheets
La sintaxis parece mucho más complicada de lo que es.
Para que te familiarices con la función, te enseñaré algunos ejemplos. Echa un vistazo a la captura de pantalla de abajo.
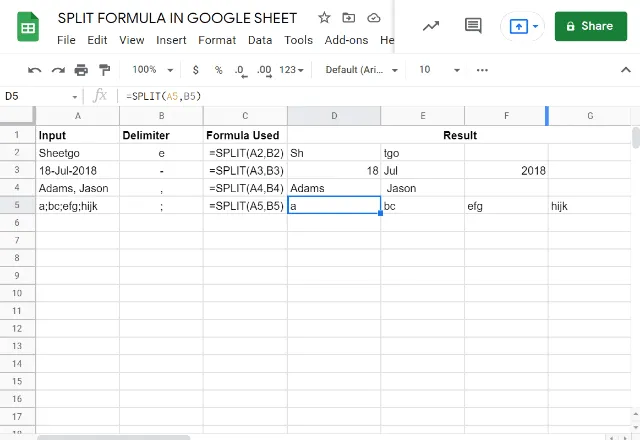
Como ves, los resultados son el texto de entrada dividido en partes en los puntos donde aparecen los delimitadores. En el primer ejemplo, el delimitador es "e", así que el resultado es una celda con todo el texto anterior a las "e" de "Sheetgo" y otra celda con todo el texto posterior. Lo consigo escribiendo =Split(A2,B2).
Lo mismo ocurre con los demás ejemplos. En cada uno, indico un delimitador y la función divide el texto en los fragmentos que van antes, entre y después de los delimitadores. Esto es muy práctico para separar datos de texto, como nombres y apellidos separados por una coma, como en el tercer ejemplo de arriba.
Consejo: deja columnas vacías a la derecha
He introducido todas las funciones en la columna D. Esto se debe a que la función SPLIT de Google Sheets distribuye su resultado en varias celdas hacia la derecha, como ocurre en todos los ejemplos. Por eso es muy importante que las celdas donde esperas que aparezcan los datos estén vacías. De lo contrario, la función devuelve un error #REF!.
Estos primeros ejemplos muestran la función SPLIT en su forma más básica. No he indicado los parámetros opcionales, así que se han quedado con su valor predeterminado. Ahora te mostraré qué pasa cuando añades los parámetros opcionales split_by_each y remove_empty_text.
Función SPLIT con el parámetro split_by_each
El split_by_each se usa cuando el delimitador tiene más de un carácter. Como ves en la imagen de abajo, cambiar este parámetro puede tener un gran impacto en el resultado de la función.

En este ejemplo, divido la palabra "Countries" con el delimitador "one".
El valor predeterminado del parámetro split_by_each es 1 (TRUE), lo que indica a la función que tenga en cuenta cada carácter del delimitador. Así, con esta opción, la función usa "o", "n" y "e" como delimitadores individuales. Puedes ver el resultado arriba: el texto "Countries" se divide en cuatro partes.
El siguiente ejemplo usa para el parámetro split_by_each el valor 0 (FALSE), que indica a la función que trate el texto del delimitador como un único delimitador de varios caracteres. En este caso, la función solo divide el texto cuando encuentra la palabra completa "one". Como "one" no aparece en "Countries", el texto no se divide. Esto demuestra la gran diferencia de resultados que se produce al cambiar el parámetro split_by_each cuando se usa un delimitador de varios caracteres.
Función SPLIT con el parámetro remove_empty_text
Ahora te mostraré un ejemplo con remove_empty_text como parámetro. Se usa cuando hay delimitadores consecutivos en el texto.
Si el parámetro es TRUE (valor predeterminado), trata los delimitadores consecutivos como uno solo; si es FALSE, los trata como delimitadores individuales y añade celdas vacías al resultado.
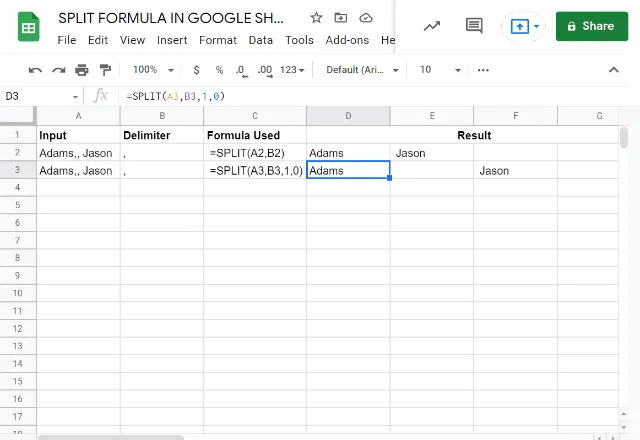
Aquí puedes ver la diferencia. Tengo una cadena de texto con delimitadores consecutivos: en este caso, dos comas seguidas.
En el caso predeterminado, en el que el parámetro remove_empty_text es 1 (TRUE), la función trata las comas consecutivas como una sola y devuelve el texto dividido como se esperaba.
En el segundo caso, en cambio, he establecido el parámetro remove_empty_text en 0 (FALSE). Ahora la función trata cada coma como un delimitador independiente, así que añade una celda vacía al resultado para reflejar el "espacio" (aunque no haya ningún carácter de espacio) entre las dos comas.
Función SPLIT: puntos a tener en cuenta
Hay algunas cosas que debes tener en cuenta al usar la función SPLIT. Primero, asegúrate siempre de tener suficientes celdas vacías a la derecha, ya que la función SPLIT puede devolver resultados en varias celdas.
En segundo lugar, recuerda que el delimitador siempre se elimina del texto. Por ejemplo, si separas cadenas de texto por comas, la coma no aparecerá en ninguna de las celdas del resultado.
Por último, también puedes dividir texto seleccionando Datos > Dividir texto en columnas. Sin embargo, este método es menos versátil, así que puede que te convenga más usar la función SPLIT. ¡Prueba las dos opciones y compruébalo tú mismo!
Para hacer lo contrario y volver a unir valores en una sola celda con un delimitador, usa TEXTJOIN en Google Sheets.
¿Trabajas con Excel? Aquí te explicamos cómo dividir celdas en Excel, incluso con su función TEXTSPLIT.
Nota del editor: Esta es una versión revisada de un post anterior que se ha actualizado para mayor precisión y exhaustividad.

 Una herramienta para combinar, dividir y filtrar todos los datos de una hoja de cálculo
Descubra cómo

 English
 Español
 Português do Brasil
 Français